Fine-tuning (ince ayar), önceden eğitilmiş bir modeli etiketli veri setinizle yeniden eğiterek ağırlıklarını göreve uyarlamaktır. Prompt ve RAG ağırlığı değiştirmez. LoRA/PEFT az parametre günceller; tam FT hepsini. Sıfırdan eğitim değildir.
Fine Tuning Nedir?
Fine tuning nedir sorusunun yanıtı: Google’ın tanımıyla, önceden eğitilmiş bir büyük dil modelini (LLM) göreve özel bir veri setinde daha fazla eğitmek (aktarım öğrenmesi). Genel bilgiyi öğrenmiş model, sizin jargonunuz, biçiminiz veya sınıflandırmanız için uzmanlaşır. Özet: Google Cloud fine-tuning. Vertex: temel modeli kendi etiketli setinizde yeniden eğitmek, ağırlıkları göreve uyarlamak — Gemini tuning.
Google önerisi: önce prompt; yetmezse ince ayar. Vertex, SFT için kabaca 100+ etiketli örnek ve karmaşık/benzersiz görevden bahseder. Nitelik nicelikten önce gelir; üretimdeki prompt dağılımına benzeyen veri kullanın. Hata nerede diye bakmadan örnek yığmayın.
Fine Tuning Ne İşe Yarar?
Vertex’e göre: göreve özel kalite, daha sağlam model, daha kısa prompt sayesinde çıkarım gecikmesi ve maliyeti. Prompt’a göre: özel sözdizimi, talimat, alan semantiği; daha tutarlı çıktı; few-shot örnekleri her istekte taşımayı kesmek.
Google Cloud, ince ayarı şu durumlarda düşünün der: sektör jargonu, belirli görev doğruluğu, marka sesi/ton, sıfırdan eğitime göre sınırlı veriyle uzmanlaşma, yüksek hacimde küçük ince ayarlı model, prompt’un çözemediği uç durumlar. Riskler (aynı kaynak): katastrofik unutma (eski genel yeteneğin zayıflaması), yüksek kaynak, veri talebi, aşırı öğrenme.
Prompt, RAG, SFT, LoRA
- Prompt: ağırlık değişmez; talimat ve bağlam istekte gider. Az veri, hızlı prototip.
- RAG: her sorguda sizin verinizden parça çekilir, prompt’a eklenir. Ağırlık değişmez. Kaynak gösterme, sık güncellenen veya özel veri, erişim kontrolü için ince ayardan önce gelir.
- SFT (denetimli ince ayar): girdi–çıktı çiftleri. Sınıflandırma, yapılandırılmış çıktı, alan özeti. Vertex: model yeni parametreler öğrenir; iş sonunda orijinal + yeni parametre birleşir. Tercih ayarı (preference) öznel ton için insan geri bildirimi ekler.
- PEFT / LoRA: parametre-etkin ince ayar (adapter). Vertex: küçük bir parametre alt kümesi güncellenir; tam FT’ye göre daha az hesap, daha küçük set, daha hızlı uyarlama. PEFT: LoRA taban ağırlığı dondurur, düşük mertebeli matrislere ayırır. Windows’ta yerel örnek: Phi Silica LoRA (NPU/GPU iş akışı ayrı).
- Tam fine-tuning: tüm parametreler. Vertex: karmaşık görev, daha yüksek kalite potansiyeli, eğitim ve servis maliyeti yüksek.
Yöntemler birleşebilir: marka sesi için ince ayar + güncel bilgi için RAG. Damıtma (distillation): büyük model küçük modele öğretmenlik eder. RLHF: iki yanıttan tercih edileni işaretlemek; ton gibi ölçülmesi zor hedefler.
Açık ağırlık lisansı ince ayara izin verebilir; 2.8T küme işidir: Kimi K3 piyasaya etkisi. Cihaz içi NPU Copilot+ katmanı ayrıdır: NPU nedir. Eğitim paraleli: CUDA çekirdeği. Prompt taslağı: Gemini prompt.
Kimler İçin Daha Uygun?
Sabit biçim, sınıflandırma, alan jargonu, tekrarlayan stil. Katalog her gün değişiyorsa önce RAG. Sıfır etiketli örnekte prompt. Tüketici GPU: küçük açık model + LoRA mümkün; tam 2.8T SFT ev kartında yok. Bulut API’ye müşteri sırrı yüklemeden önce sözleşme ve silme politikası.
Game Garaj Önerileri
Küçük model LoRA için VRAM’li GPU; ajan/API için laptop. K3 ölçeği ayrı kümedir.
 Laptop
Game Garaj Slayer R9T-5070 AMD Ryzen 9 8945HX
Prompt, eval ve API ince ayar işi; 2.8T tam FT bu kutuda değil.
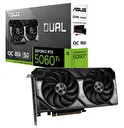 GPU
ASUS Dual RTX 5060 Ti O8G 8GB GDDR7
Küçük model LoRA / CUDA; tam FT VRAM ve küme ölçeğine bakın.
Dikkat Edilmesi Gereken Noktalar
İnce ayar güncel bilgi enjekte etmez; o RAG’dir. Kirli etiket = kirli davranış. Test setini eğitimden ayırın. Ticari API ince ayarı sağlayıcıya göre açılır veya kapanır; güncel dokümana bakın. Lisans (ör. Kimi K3 License) ince ayara izin verse bile donanım eşiği ayrıdır.
Genel Değerlendirme
Fine-tuning, ön eğitimli modelin ağırlıklarını sizin etiketli görevinize çekmektir. Prompt ve RAG’den sonra gelir. LoRA/PEFT tüketici GPU’da küçük modeller için pratik yoldur; tam FT ve 3T sınıfı açık modeller veri merkezi işidir. Kaliteli az örnek, yığılan kötü veriden iyidir.
Bu Yazı ile İlgili Sıkça Sorulan Sorular
Önceden eğitilmiş LLM’i etiketli görev verinizle yeniden eğitmek. Ağırlıklar (veya LoRA’da adapter) değişir. Sıfırdan eğitim değildir.
RAG ağırlığı değiştirmez; ilgili belge parçasını prompt’a koyar. İnce ayar parametreleri değiştirir. Kaynak ve taze veri için RAG; stil ve biçim için ince ayar. İkisi birlikte de kullanılır.
PEFT yöntemi: taban donar, düşük mertebeli (LoRA) matrisler eğitilir. Tam FT’den az VRAM ve depolama. Küçük açık modellerde tüketici GPU’ya daha yakındır.
Küçük model + LoRA için belki. Tam FT ve 2.8T sınıfı modeller küme ister. NPU Copilot+ ince ayar kümesi değildir.
Vertex SFT için kabaca 100+ etiketli örnekten söz eder; kalite ve üretim prompt’una benzerlik sayısından önemlidir. Az veride prompt yeter.